PDF → Markdown
PDF を Markdown に変換
PDF ファイルから、LLM 向けに最適化したきれいな Markdown を。ブラウザ内で直接処理、アップロード不要。
100% ブラウザ内で処理登録不要GDPR 準拠無料
PDF、ほかの形式にも対応
ここにファイルをドロップ
またはクリックして選択、1 ファイル最大 25 MB、複数同時に
PDF
Bilder
CSV/XLSX
DOCX
PPTX
HTML/MD
例: PDF から Markdown
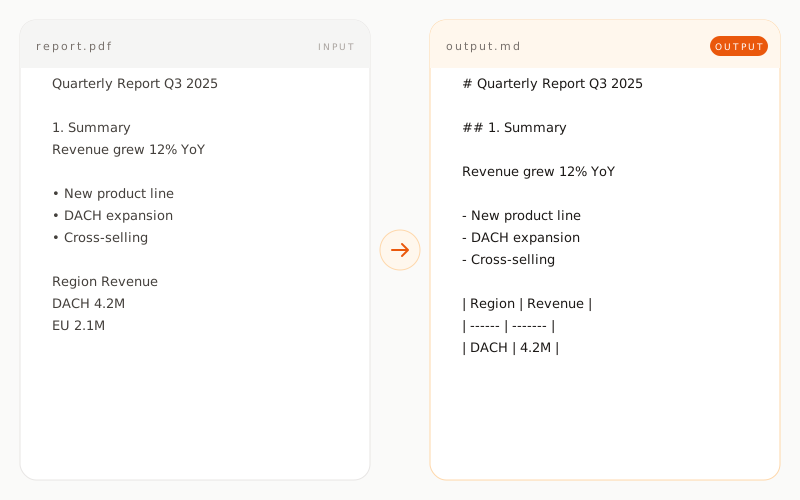
document.pdf入力
2025年 第3四半期 決算報告

1. 概要
売上高は前年比 12% 増加しました。
主な要因:
• 新製品ライン
• 関西エリアへの展開
• クロスセル

地域      売上高
東京      4.2M
大阪      2.1M
document.md出力
# 2025年 第3四半期 決算報告

## 1. 概要

売上高は前年比 12% 増加しました。

主な要因:

- 新製品ライン
- 関西エリアへの展開
- クロスセル

| 地域 | 売上高 |
| ------ | ------- |
| 東京   | 4.2M    |
| 大阪     | 2.1M    |
PDF の変換はどのように行われますか?
01 / タイプ A
テキストベースの PDF
デジタルで作成された PDF では、埋め込まれたテキストストリームを直接読み取ります。高速かつ正確で、情報の欠落もありません。Markdown は意味を表す形式なので、フォント、サイズ、色は意図的に省かれます。残るのは見出し、段落、リスト、表で、Claude、ChatGPT、Gemini などの言語モデルがそのまま処理できる形になります。一般的な 20 ページの PDF なら、すべてブラウザ内で 2 秒以内に変換できます。
02 / タイプ B
スキャンした PDF
PDF に画像しか含まれていない場合、つまりスキャンされたものである場合、ツールが自動で判別し、Tesseract による OCR を実行します。OCR は WebAssembly によって完全にブラウザ内で動作し、データがサーバーに送られることは一切ありません。認識精度はスキャンの解像度と元の言語に大きく左右されます。300 DPI 以上のきれいなスキャンなら、通常 95% を超える精度が得られます。手書きのメモは確実には認識できません。
03 / タイプ C
段組みレイアウトと表
学術論文、雑誌、報告書は段組みが多用されがちです。このツールはそうしたレイアウトを上から下への論理的な読み順に並べ直すため、Markdown 出力を通して読むことができます。表は、列の構造とセルの境界が検出できる限り、きちんとした Markdown の表として再構成されます。非常に複雑な入れ子の表では簡略化されることがあるため、その場合は出力をざっと目視で確認することをおすすめします。
何が保持され、何が失われますか?
保持 変換 除去
見出し
H1、H2、H3 として保持
本文
段落として保持
リスト
Markdown のリストとして保持
表
Markdown の表として保持
脚注
Markdown の脚注として保持
画像
参照または OCR テキストとして
段組みレイアウト
上から下へ一列に並べ替え
ページ番号とヘッダー
除去(LLM にとってノイズ)
フォントと色
除去(Markdown は意味を表す形式)
PDF を Markdown に変換すると便利なのはどんなとき?